Claude 能转录音频吗?我们用一段可打分的 MP3 实测
Claude 没有语音转文字功能,但会在代码沙盒里自己搭一个。我们用同一段可打分的 MP3,分别计时了这种做法、转录连接器和 Claude Code。
简短回答:没有内置功能,但它会自己想办法。 Claude 没有语音识别模型,Anthropic 的上传说明里也没有任何音频或视频格式。我们照样附上了一个 MP3,Claude 接受了,在自己的代码沙盒里装了一个开源 Whisper 模型,最后交出一份质量不错的文字稿,用时约 21 分钟。换成 Claude Code 加转录命令行工具,38 秒就拿到了同样的文字。
目前让文字稿进入 Claude 有四种方式:
- **附上文件,让 Claude 自己想办法。**它会写代码、跑代码来转录。慢,但我们测试时成功了。
- 加一个转录连接器(MCP 服务器),让 Claude 调用它。
- 用 Claude Code,在你自己的电脑上跑转录命令行工具。
- 在别处转好,把文字粘贴进来,再让 Claude 处理。
语音模式不算其中一种。按 Anthropic 的语音模式说明,它把你说的话变成聊天消息,然后删除录音,不会去读你手里已有的文件。
Claude 官方说能读什么
Anthropic 的上传说明(2026 年 7 月 23 日更新,我们 11 月 18 日查看)列出的是文档(PDF、DOCX、CSV、TXT、HTML、ODT、RTF、EPUB、JSON、XLSX)和图片(JPEG、PNG、GIF、WebP),单个文件最大 500 MB,每个对话最多 20 个文件。没有任何音频或视频格式。
这份清单没提代码沙盒。打开代码执行和文件创建之后(帮助页说所有套餐都有,包括免费版),附上的文件还会被复制到一个 Linux 沙盒里,Claude 可以在里面运行程序处理它。我们测试时,MP3 出现在沙盒的 /mnt/user-data/uploads/ 下,Claude 就是这样拿到它的。
测试:一段可打分的 MP3,一条提示词
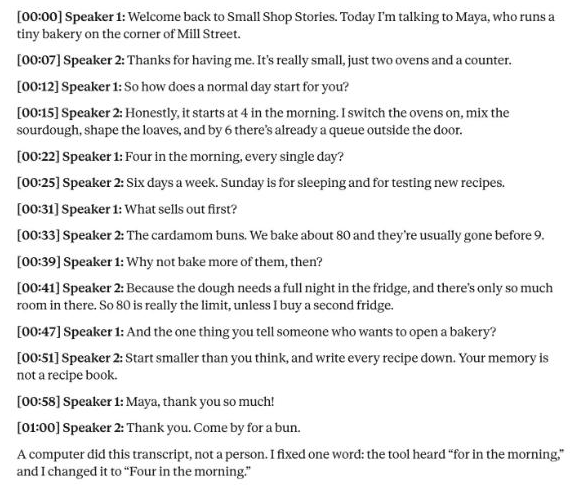
用的是文字稿示例和 ChatGPT 测试里的同一段录音:64 秒、两人对话的访谈,由一份 189 词、14 个说话人轮次的脚本,用两种合成语音生成。脚本是我们写的,所以任何文字稿都能逐词打分。
每次都用 podcast-bakery-interview.mp3(约 1 MB)和这条提示词:
Transcribe this audio word for word. Label each speaker (Speaker 1,
Speaker 2) and give a timestamp at the start of each speaker turn.
所有 Claude 测试都在 Pro 账号上进行,模型 Opus 5.5,时间 2026 年 11 月 18 日。
| 路线 | 拿到文字稿的时间 | 真实错误(共 189 词) | 说话人轮次正确 |
|---|---|---|---|
| Claude 自己(代码沙盒) | 约 21 分钟 | Claude 自行修正后 1 处;模型原始输出 2 处 | 重跑后 14/14;第一遍 12/14 |
| Claude + ScribeToAny 连接器,附件方式 | Claude 约 80 秒,外加手动上传一次(GPU 用时 21 秒) | 2 处 | 14/14 |
Claude Code + scribetoany 命令行 | 38 秒 | 2 处 | 14/14 |
"真实错误"不算把数字词写成阿拉伯数字("four" 写成 "4"),每条路线都这样做了。
Claude 自己转:21 分钟的即兴发挥
我们关掉所有连接器,附上 MP3,发出提示词。Claude 没有拒绝。它先找转录工具,没找到,就开始自己搭:
- 先试
pip install faster-whisper和一个说话人声纹库。安装撞上了沙盒单条命令 10 分钟的上限,被转到后台。 - 它检查了沙盒能访问哪些下载站点,然后从 GitHub releases 下载了两个现成模型:Whisper medium.en(
sherpa-onnx格式)和一个用于区分说话人的 pyannote 分段模型。 - 用
ffmpeg把 MP3 转成 16 kHz 的 WAV,写了一个transcribe.py并运行。 - 第一遍在两人访谈里识别出了四个说话人。Claude 指定两人重跑,然后给出答案。
整轮用了大约 21 分钟。结果本身不错:
| 检查项 | 结果 |
|---|---|
| 与脚本不同的词(模型原始输出) | 2 处真实错误:"Four in the morning?" 识别成 "for in the morning","the one thing you'd tell" 识别成 "you tell" |
| Claude 改了什么 | 根据上下文把 "for" 改成 "Four",并在文字稿下方说明了这处修改 |
| 最终文字稿 | 1 处真实错误("you'd" → "you") |
| 说话人轮次 | 第一遍 12/14(两个主持人的问题被标成 "Speaker 3" 和 "Speaker 4"),重跑后 14/14 |
| 时间戳 | 每个轮次一个,符合要求 |
这两处模型错误,和我们自己的引擎在文字稿示例测试里犯的一模一样。这不奇怪:两者都是 Whisper 模型,"four" 和 "for" 发音相同。
用这条路线之前要想清楚几点:
- **64 秒的音频花了 21 分钟。**大部分时间在搭环境,而每开一个新对话都要从头来一遍,因为沙盒不会保留装好的模型。
- 它是一轮很长的智能体任务,在 Opus 上跑了十几条命令。在有用量上限的套餐里,一小时的音频未必跑得完。
- **每个对话的做法都不一样。**工具是 Claude 每次自己选的。我们这次拿到的是 Whisper medium.en,下次可能换成更小的模型,也可能下载失败。
- **Claude 改了文字稿。**这次改对了,也说明了,但被语言模型修正过的"逐字稿"已经不是逐字稿。要引用原话,请对照录音核对。
用转录连接器:多一步上传,然后拿到文字稿
连接器是给 Claude 增加工具的 MCP 服务器。ScribeToAny 就是我们做的其中一个,读这一节时请记住这一点。自定义连接器所有套餐都能用,但 Anthropic 的连接器说明规定免费版只能加一个自定义连接器。
我们打开 ScribeToAny 连接器,附上同一个 MP3,让 Claude "use ScribeToAny to transcribe this audio",后面接上测试提示词。大约 50 秒后,Claude 回答说 ScribeToAny 拿不到对话里的文件,并给了一个上传链接:打开链接、在那边上传文件、回来说一声 "done"。
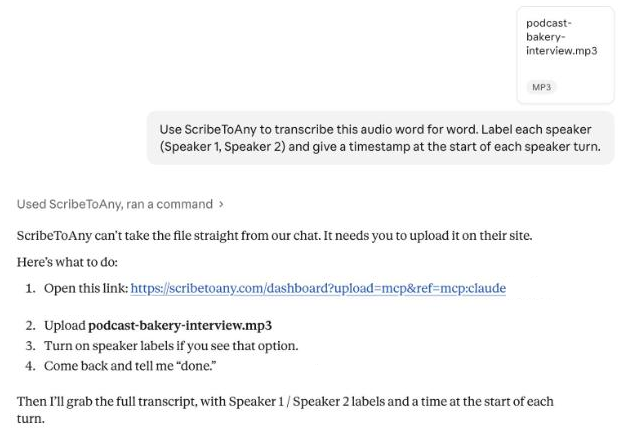
我们照着做了:打开链接,用 Accurate 模式上传 MP3,说话人识别设为两人,然后输入 "done"。转录本身用了 21 秒 GPU 时间。之后 Claude 取回结果,大约 30 秒就给出答复,格式正是提示词要求的:每个说话人轮次一段,带 Speaker 1 / Speaker 2 标签,每段开头有 [m:ss] 时间戳。
| 检查项 | 结果 |
|---|---|
| 真实错误 | 2 处,和其他路线的模型原始输出一样("for in the morning"、"you tell") |
| 说话人轮次正确 | 14/14 |
| 时间戳 | 每个轮次一个,符合要求 |
| Claude 改动了什么 | 没有。它保留了引擎写的 "For in the morning",并在文字稿下方标注这里大概是 "Four" |
最后一行就是它和沙盒路线的区别:文字是引擎的原样输出,Claude 指出可疑之处,但不在文字稿里改动。
为什么要多一步上传?附上的文件留在 Claude 的沙盒里;连接器运行在别人的服务器上,只能收到 Claude 在工具调用里发出的参数,那是文本,不是你的文件。我们预计其他连接器也一样,所以用任何转录连接器处理本地文件,都只有两条路:
- 在服务方网站上传,用连接器给的链接,传完再让 Claude 取文字稿。
- 粘贴媒体链接,而不是附上文件。ScribeToAny 能抓取 X、Twitch、Loom、Google Drive、Dropbox 的公开链接和媒体直链;其他连接器支持什么,请自行确认。
我们踩到的一个坑:上传链接会在浏览器里打开服务方网站,文字稿会进入浏览器当前登录的那个账号。如果它和你连接到 Claude 的不是同一个账号,Claude 就找不到这份文字稿。
在 claude.ai 上添加连接器:进入 Customize → Connectors,点 + Add → Add custom connector,粘贴服务器地址并登录。ScribeToAny 的地址和一键添加按钮在 ScribeToAny for Claude。
Claude Code:本地文件一条命令
Claude Code 跑在你自己的电脑上,所以能把本地文件交给任何转录命令行工具。我们用的是自家的 scribetoany(再说一次:这是我们做的),账号是 ScribeToAny 免费版:
npm i -g scribetoany
scribetoany auth login
scribetoany transcribe podcast-bakery-interview.mp3 --speakers 2 --format srt
auth login 只在第一次打开浏览器登录。在 Claude Code 里还可以把配套技能装成插件(先 /plugin marketplace add scribetoany/skills,再 /plugin install scribetoany@scribetoany-skills),之后一句"转录这个文件"就够了。
端到端用了 38 秒,输出一个含 30 条字幕的 .srt 文件。对照脚本打分:
| 检查项 | 结果 |
|---|---|
| 真实错误 | 2 处,和上面那两处一样("for in the morning"、"you tell") |
| 说话人轮次正确 | 14/14 |
| 输出 | 30 个带时间的片段,可存为 TXT 或 SRT |
| 改动了什么 | 没有:它不修改文字,所以 "for" 还是 "for" |
各路线对比
| 路线 | 能直接处理电脑上的文件吗 | 谁能用 | 说话人标签 | 时间戳 | 字幕文件(SRT/VTT) |
|---|---|---|---|---|---|
| Claude 自己(代码沙盒) | 能,附上即可 | Anthropic 称所有套餐都有沙盒;我们只测了 Pro | 看它搭不搭 | 要求就有 | 看它写不写 |
| 语音模式 | 不能,只处理实时说话 | 所有套餐(测试版) | 无 | 无 | 无 |
| 转录连接器 | 通过服务方上传页或链接 | 所有套餐;免费版限一个自定义连接器 | 取决于服务 | 取决于服务 | 取决于服务 |
| Claude Code + 命令行工具 | 能,直接处理 | Claude Code 用户 | 有,用命令行选项 | 有 | 有 |
| 别处转好,粘贴文字 | 能 | 所有人 | 取决于所用工具 | 取决于所用工具 | 取决于所用工具 |
该选哪条
- **一个短文件,不赶时间,什么都不想装:**附上文件,让 Claude 自己搭。要等一阵,人名和数字记得核对。
- **经常要转录,或者录音很长:**用连接器。专门的引擎、说话人标签、字幕文件都有,文字稿还留在你的账号里,之后的对话也能取用。
- **一整个文件夹,或者要写脚本:**用 Claude Code 加命令行工具。
- **只需要 Claude 总结或回答问题:**在哪转都行,再把文字粘贴或附上。TXT、DOCX、PDF 格式的文字稿,Claude 和读其他文档一样读。
我们没有测的
- **免费版。**Anthropic 说所有套餐都有代码沙盒,但 21 分钟的智能体任务可能会碰到免费版的用量上限。我们只在 Pro 上跑过。
- **长录音或嘈杂录音。**一分钟干净的合成语音是最理想的情况。真实录音对准确率的影响,见 AI 转录到底有多准。
- **视频文件。**Claude 的沙盒里有
ffmpeg,大概能从 MP4 里把音频提出来,但我们没试。 - **其他连接器。**我们只测了自己的。
拿到文字稿后,再问 Claude
文字一旦进了对话,就轮到 Claude 发挥长处了。我们常用的提示词:
Here is a transcript with speaker labels and timestamps. List each
speaker's main points, quote the three most important sentences with
their timestamps, and flag any word that looks like a transcription
error.
两人访谈的话,再让它把 "Speaker 1"、"Speaker 2" 换成真名。分清每段话什么时候换人是一回事,认出每个声音是谁是另一回事,后者是说话人分离里任何模型都没法只靠音频完成的部分。